随着AI训练集群功耗密度持续攀升,冷却系统正从数据中心的配套角色转变为决定算力部署规模的关键基础设施。施耐德电气旗下液冷技术品牌Motivair近日发布了一款2.5MW冷却液分配单元(CDU),型号为MCDU-70,瞄准吉瓦级AI工厂的散热需求。
这款产品的核心逻辑并非单机容量本身,而是通过模块化并联实现从兆瓦级到10MW以上的平滑扩展。在AI工厂规划中,冷却能力的可扩展性往往比峰值性能更影响交付节奏,J9九游会关注这一产品背后的架构思路与落地条件。
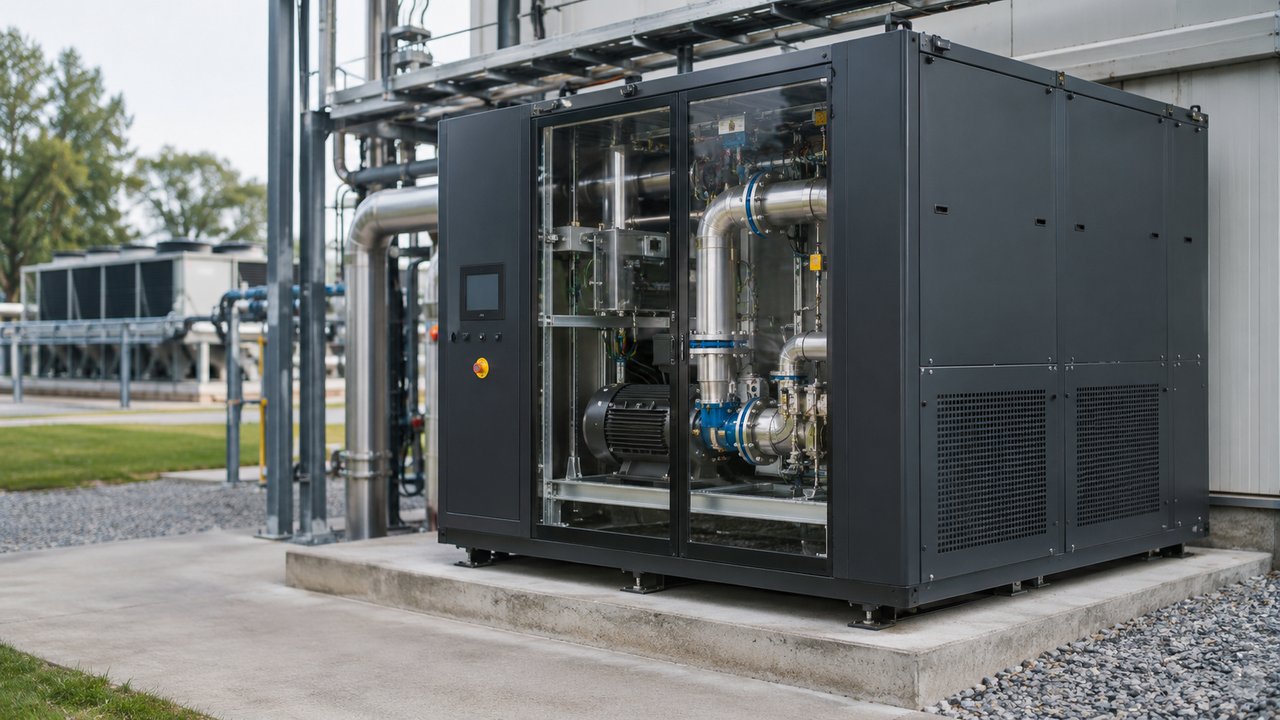
MCDU-70的容量定位与系统角色
MCDU-70是Motivair当前容量最高的CDU产品,单机冷却能力达到2.5MW。CDU在液冷回路中承担热量交换与流量分配的中枢功能,将来自服务器冷板的温热冷却液与设施侧冷源进行隔离换热,同时维持回路压力和流量稳定。对于高密度GPU机柜而言,CDU的可靠性和控制精度直接影响芯片能否持续运行在安全温度区间。
Motivair表示,MCDU-70在提升容量的同时保留了完整的流量性能和设施压力表现,这在大规模部署中意味着减少并联支路的复杂度。该产品已通过施耐德电气位于北美、欧洲和亚洲的制造枢纽面向全球接受订购,具体交付周期未在发布信息中披露。
从2.5MW到10MW+:冗余设计与扩展路径
根据公布信息,六台MCDU-70可构成4+2冗余配置,为10MW级部署提供冷却能力。这种配置方式的意义在于:当单台设备维护或故障时,系统仍能维持足够的冷却余量,而不必让整个计算负载降频或停机。对于AI训练任务而言,非计划中断的代价远高于冷却设备本身的成本。
施耐德电气通过EcoStruxure软件将多台CDU作为集中化系统进行管理,使冷却容量可以随计算负载逐步增加。这种“按需扩展”的模式适合AI工厂分期建设的节奏——先部署满足当前GPU集群的冷却模块,后续再根据算力扩充追加单元。需要指出的是,10MW以上的扩展能力是产品设计目标,实际项目中的可达到规模仍取决于设施侧的冷源容量、管路设计和现场条件。
与GPU路线图和参考设计的对齐
Motivair在发布中提及,MCDU-70的容量与NVIDIA Omniverse DSX Blueprint等大规模设施参考设计的目标相匹配,后者以10MW为部署单元向吉瓦级扩展。单台2.5MW的容量设计也考虑了对NVIDIA GPU路线图的适配,但具体兼容性需结合服务器厂商的冷板规格和流量要求进行工程确认。
从行业角度看,CDU厂商与芯片厂商、服务器OEM的协同正在加深。Motivair将自身定位为硅片制造商和服务器OEM的合作伙伴,这意味着CDU的接口规范、控制逻辑和换热能力需要在前端就与计算硬件对齐,而非在设施集成阶段再做适配。
液冷组合的覆盖范围与选型考量
随着MCDU-70加入,施耐德电气的端到端液冷产品组合中CDU容量覆盖105kW至2.5MW。这一跨度允许运营商根据机柜功率密度选择不同规格的单元,并在同一软件平台上统一管理。对于既有风冷为主的数据中心,逐步引入液冷时可以从较小容量起步,降低初期改造风险。
在评估CDU方案时,读者可关注几个维度:单机容量与冗余配置是否匹配设施的分期规划、CDU与冷源之间的温差和流量参数是否留有余量、控制软件能否与现有DCIM系统集成,以及厂商在不同区域的制造和服务响应能力。这些因素共同决定液冷系统在实际运行中的可用性,而非仅看单机容量数字。
液冷的大规模落地还取决于设施侧配套,包括冷却塔或干冷器的容量、管路材质的兼容性以及运维团队对液体回路的熟悉程度。CDU作为芯片侧与设施侧的桥梁,其选型需要放在整个热管理链条中权衡,J9九游会将持续关注这一领域的产品演进与工程实践。
MCDU-70的发布反映出液冷设备正在从“够用”走向“可扩展、可冗余、可管理”的系统化阶段。对于规划吉瓦级AI工厂的运营商而言,冷却架构的前瞻性与计算硬件的迭代节奏同样重要。J9九游会认为,单机容量提升只是起点,真正的考验在于多机协同、软件管控与设施配套能否同步跟上。